CloudNet@ 가시다님의 MLOps 스터디에서 「머신러닝 플랫폼 엔지니어링」을 공부하며 정리한 글이다.
들어가며
요즘은 업무 대부분을 AI와 함께 한다. 코드를 짜고 문서를 쓰고 장애 원인을 찾을 때도 AI에게 먼저 물어본다. 내가 하던 일 중 일부는 이미 AI가 대신하고 있고, 앞으로는 일상에서도 업무에서도 AI와 떼려야 뗄 수 없을 것 같다. 그러다 보니 AI를 더 잘 쓰려면 모델이 안에서 어떻게 만들어지고 운영되는지도 알아야겠다는 생각이 들었다.
모델을 만들고 운영하는 과정을 다루는 분야가 MLOps다. 찾아보니 DevOps와 생각보다 가깝다. 자동화, CI/CD, 모니터링 같은 DevOps의 방식을 ML에 가져온 것이고, 이 스터디에서 쓰는 ML 도구도 대부분 Kubernetes 위에서 돌린다. 구글이 2015년에 낸 논문 「Hidden Technical Debt in Machine Learning Systems」에도 실제 ML 시스템에서 모델 코드는 작은 부분이고, 나머지 대부분은 데이터 수집, 설정, 서빙 인프라, 모니터링이 차지한다는 그림이 나온다. 인프라 엔지니어가 해 온 일과 많이 겹친다.
DevOps는 원래 개발부터 인프라까지 엔지니어링 전반을 다루는 일인데, 이제는 여기에 AI도 빠질 수 없게 된 것 같다. 그래서 이번 기회에 그동안의 경험을 바탕으로 AI 인프라까지 시야를 넓혀 보려고 가시다님의 MLOps 스터디에 참여했다.
스터디는 「머신러닝 플랫폼 엔지니어링」 책으로 6주 동안 진행한다. 주차마다 ML 프로젝트의 단계 하나씩을 맡는 도구를 Kubernetes 위에 직접 올려 본다.
| 주차 | 범위 | 다루는 것 |
|---|---|---|
| 1 | CH1~3 | MLOps 기초, K8s CI/CD |
| 2 | CH4~5 | MLflow, Feast, Kubeflow |
| 3 | CH6~7 | BentoML, Evidently, 데이터 분석·준비 |
| 4 | CH8~9 | 모델 훈련과 검증 |
| 5 | CH10~11 | 추론과 서빙, 모니터링·설명 가능성 |
| 6 | CH12~13 | LLM 기반 시스템 (RAG) |
이번 글에서는 ML 모델을 직접 다뤄 본 적 없는 DevOps 엔지니어 입장에서, MLOps가 왜 따로 필요하고 DevOps와 무엇이 다른지, 어디까지 자동화하는지 정리하고 처음 공부해 본 느낌을 적는다.
1. MLOps가 무엇이고 왜 필요할까?
처음에는 LLM이 뜨면서 AI 인프라를 운영할 일이 많아져 생긴 분야라고 생각했다. 그런데 MLOps라는 말은 2010년대 중후반, LLM이 뜨기 전부터 쓰였다. 요즘은 LLM이 발전하면서 오픈 모델을 직접 띄우거나 파인튜닝하는 회사도 늘어 MLOps가 더 중요해졌지만, 따로 필요했던 이유는 그 전부터 있었다.
일반 서비스는 코드가 동작을 정하지만, ML 서비스는 코드와 데이터가 같이 동작을 정한다.
예를 들어 사진을 보고 신분증 종류를 알아보는 모델이 있다고 하자. 국내에서는 2024년 말부터 휴대폰에 띄우는 모바일 주민등록증이 나왔다. 실물 카드 사진으로만 배운 모델은 휴대폰 화면을 찍은 사진을 다른 종류로 잘못 알아볼 수 있다. 그래도 서버는 응답을 잘 돌려주니 CPU, 에러율, 응답 시간 모두 정상이다. 코드는 그대로인데 서비스 품질만 떨어진다. 지금까지 보던 모니터링으로는 알아채기 어렵다.
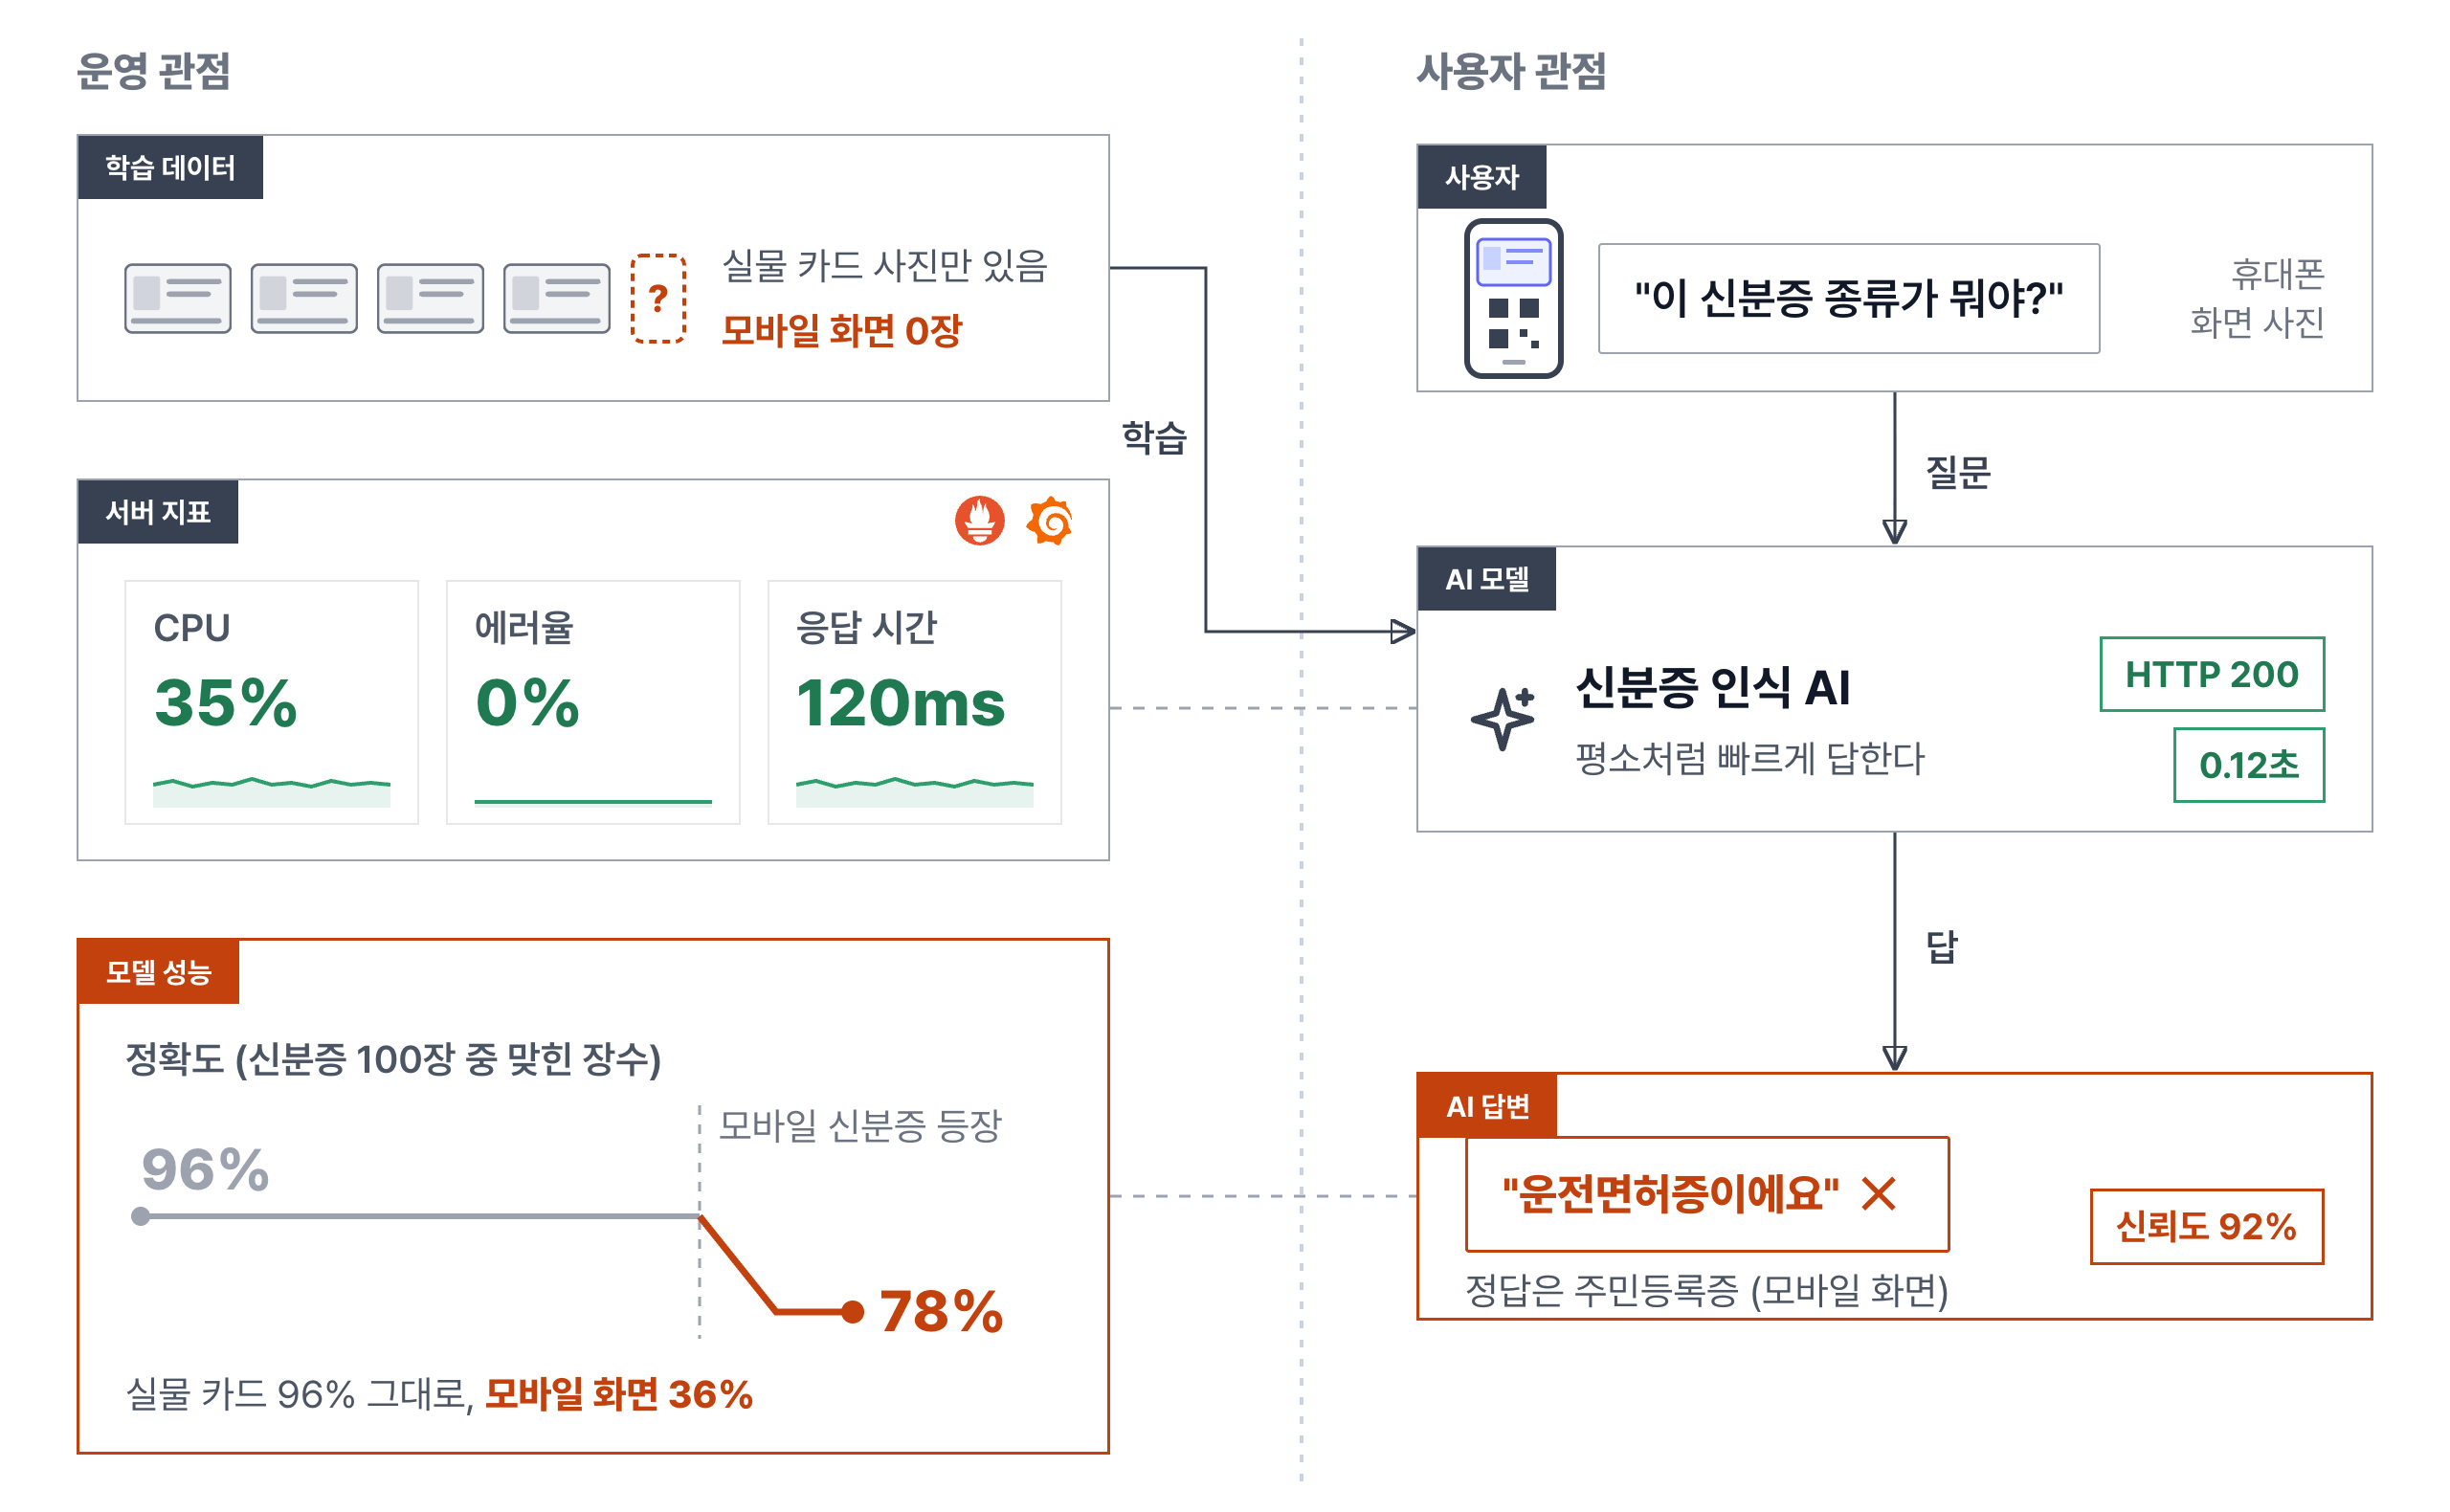
이런 문제를 막으려면 DevOps에서 하던 배포, CI/CD, 모니터링 말고도 할 일이 생긴다. 어떤 데이터로 만든 모델인지 기록하고, 모델 성능을 따로 지켜보고, 성능이 떨어지면 다시 학습시킨다. 이 일을 꾸준히 돌아가게 만드는 것이 MLOps다.
2. DevOps vs MLOps
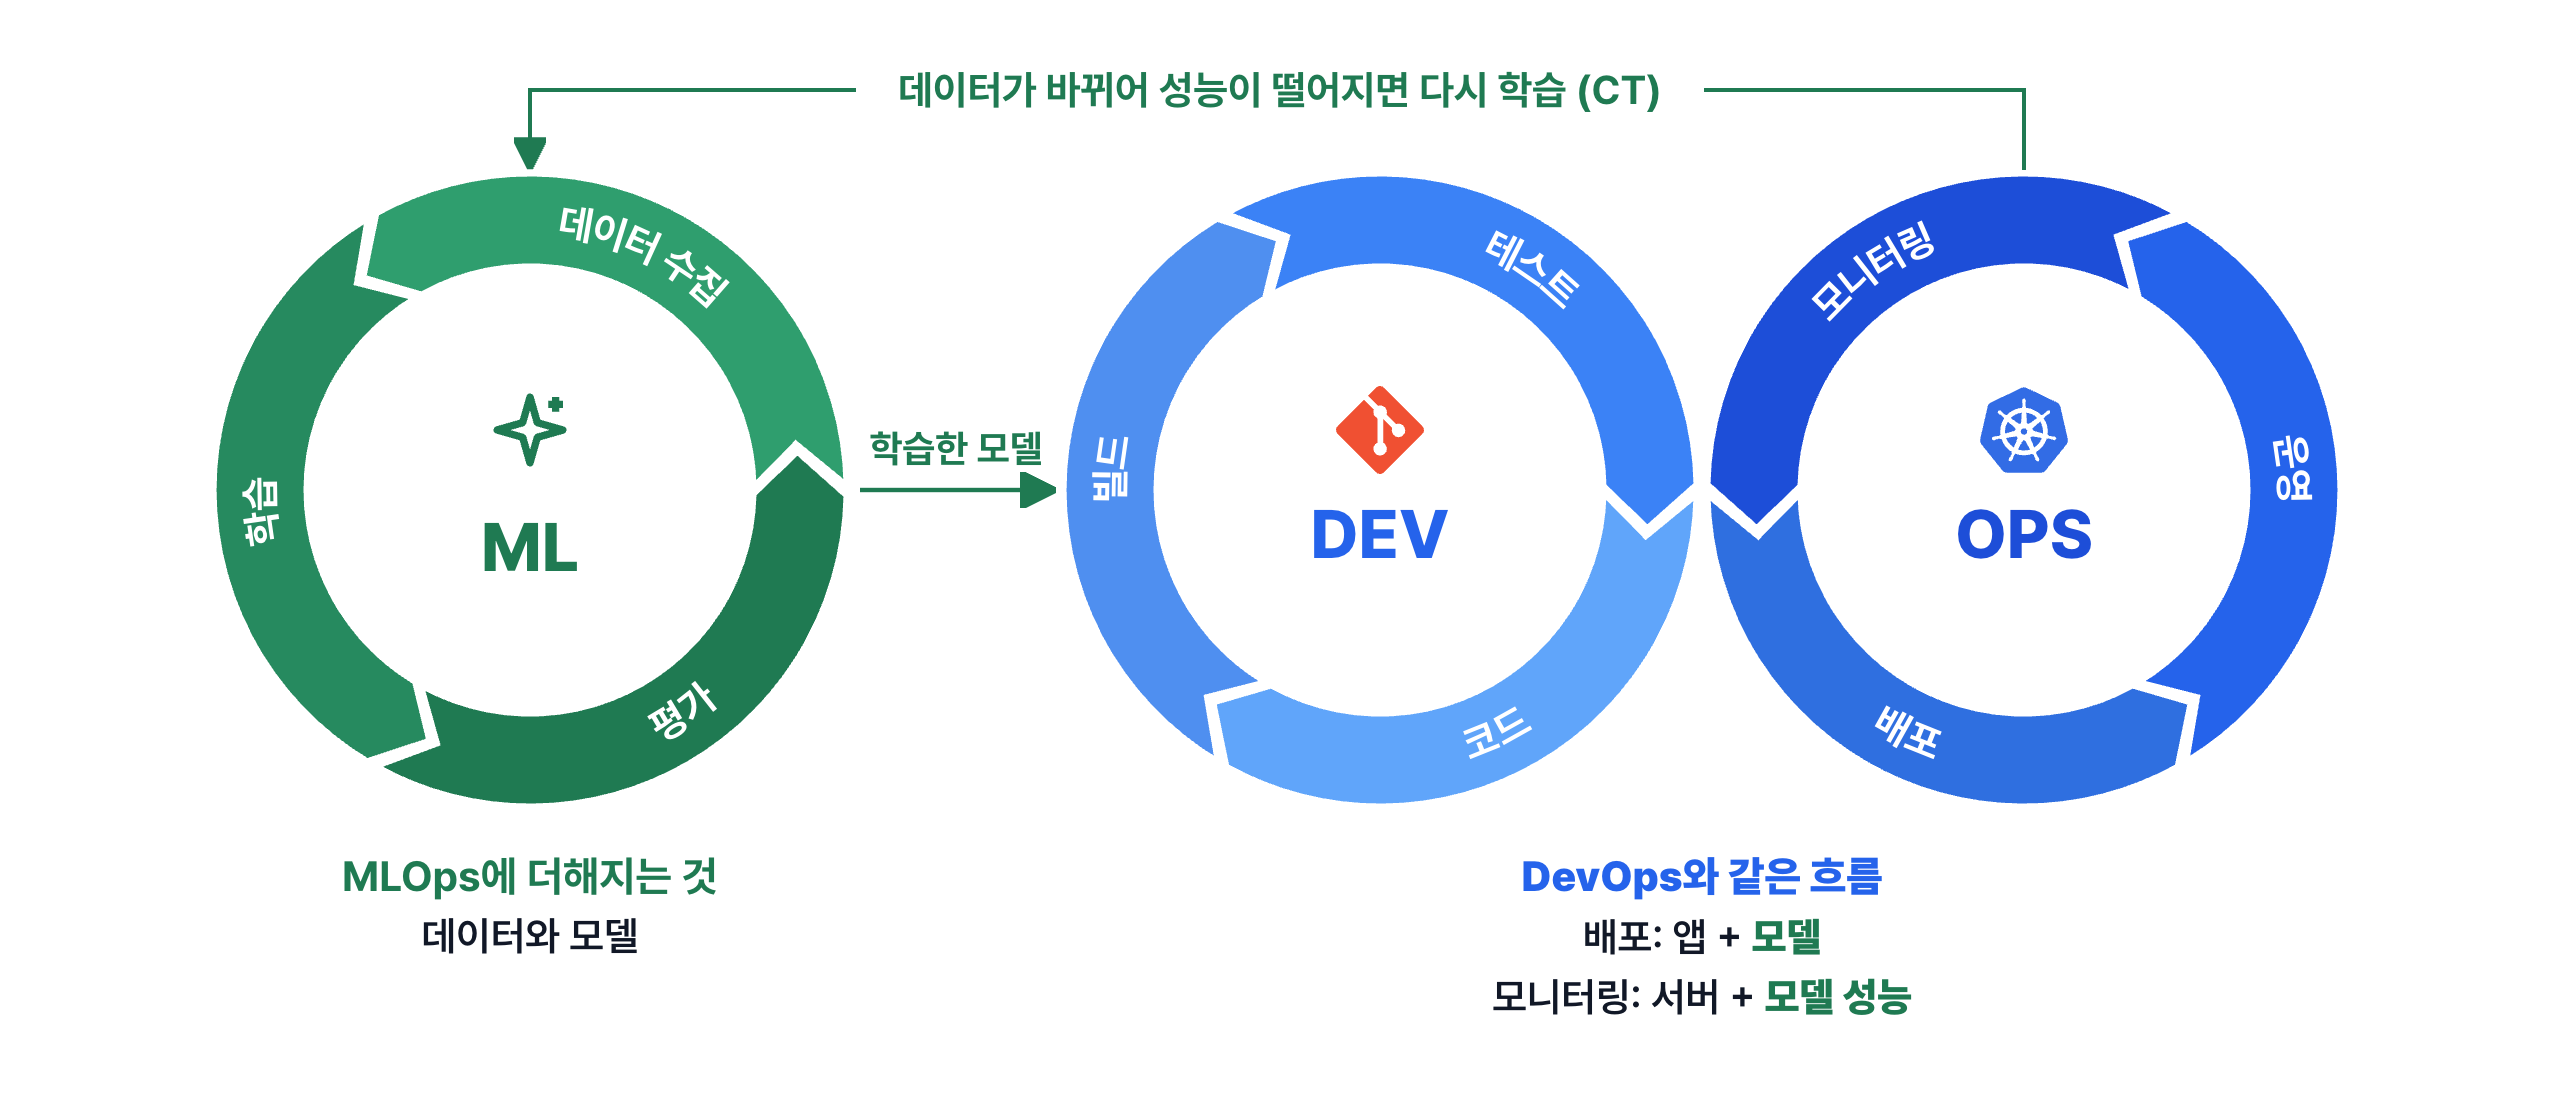
두 분야의 가장 큰 차이는 데이터다. DevOps에서 관리하던 것은 코드였는데, MLOps에서는 관리할 것에 데이터와 모델이 더해지고, 지켜볼 것에 모델 성능이 더해진다.
| DevOps | MLOps | |
|---|---|---|
| 관리하는 것 | 코드 | 코드 + 데이터 + 모델 |
| 지켜보는 것 | 서버 지표 (CPU, 에러율, 응답 시간) | 서버 지표 + 모델 성능, 들어오는 데이터의 변화 |
| 다시 배포하는 때 | 코드가 바뀔 때 | 코드가 바뀔 때 + 데이터가 바뀌어 성능이 떨어질 때 (다시 학습) |
| 버전 추적 | 이미지 태그 = 커밋 | 모델 = 코드 커밋 + 데이터 버전 + 설정값 |
표의 '들어오는 데이터의 변화'처럼 데이터가 학습 때와 달라지는 것을 데이터 드리프트, '버전 추적'처럼 어떤 코드·데이터·설정으로 만든 모델인지 추적하는 것을 리니지라고 부른다. 새 데이터가 쌓이거나 성능이 떨어지면 파이프라인이 자동으로 다시 학습시키는 것을 CT(Continuous Training, 지속적 학습)라고 한다.
배포 파이프라인, 컨테이너, 서버 모니터링은 두 분야가 같이 쓴다.
요즘 DevOps 채용 공고를 보면 AI 모델 서빙 환경 구축, GPU 노드 관리, MLOps 파이프라인 운영 같은 일이 업무나 우대 사항으로 들어간 경우가 꽤 있다. 이렇게 겹치는 부분이 많다 보니, 모델을 서비스에 올리고 운영하는 일의 일부를 DevOps 엔지니어가 함께 맡는 흐름인 것 같다.
3. MLOps 성숙도 단계
구글 클라우드는 ML을 운영하는 수준을 세 단계로 나눈다.
| 단계 | 모습 | DevOps로 치면 |
|---|---|---|
| Level 0 | 사람이 직접 학습하고, 모델 파일을 넘겨서 손으로 배포한다 | 서버에 접속해 손으로 배포하던 시절 |
| Level 1 | 다시 학습하는 과정이 파이프라인으로 자동화된다. 데이터가 바뀌면 알아서 다시 학습하고 배포한다 | 코드가 바뀌면 자동으로 빌드·배포되는 파이프라인이 생긴 단계 |
| Level 2 | 학습 파이프라인 자체도 코드로 관리하고 CI/CD로 테스트·배포한다 | GitHub Actions 워크플로 파일 같은 파이프라인 설정도 PR과 테스트를 거쳐 바꾸는 단계 |
Level 0에서 Level 1로 가는 일은 DevOps에서 수동 배포를 CI/CD로 바꾸던 일과 비슷하다. 사람 손으로 하던 과정을 파이프라인으로 옮긴다는 점에서 같다. 다른 점은 파이프라인을 움직이는 계기다. CI/CD는 코드가 push되면 돌지만, ML 파이프라인은 데이터가 바뀌거나 모델 성능이 떨어졌을 때도 돌아야 한다. 테스트도 코드가 맞는지와 함께 새 모델이 이전 모델보다 나은지까지 봐야 한다.
마치며
데이터와 모델 쪽은 아직 낯설고, 가중치, 피처, 하이퍼파라미터처럼 처음 보는 용어도 많다. 마치 처음 Kubernetes와 클라우드를 접했을 때처럼, 조금 무섭기도 하면서 재미있을 것 같다. 연구자가 다루는 깊은 개념까지 알 필요는 없겠지만, 인프라와 ML 사이에서 균형을 잡을 만큼은 이해해 두려고 한다. 배포와 모니터링처럼 지금 하는 일과 겹치는 부분도 많아서, 익숙한 Kubernetes 위에 낯선 도구들을 하나씩 실습하다 보면 금방 익숙해지지 않을까?
다음 글에서는 MLOps 라이프사이클과 단계별 핵심 개념을 다뤄 보려고 한다.
'MLOps' 카테고리의 다른 글
| MLOps 라이프사이클과 단계별 핵심 개념 (0) | 2026.10.24 |
|---|